

拆解行云集成电路 OSDI’26 录用成果:CPU–GPU 混合推理如何让万亿参数 MoE 在本地逼近云端体验
近日,行云集成电路与清华大学联合完成的 CPU–GPU 混合推理研究成果,入选国际操作系统领域顶级会议 OSDI’26。论文聚焦如何在在由通用 CPU 和消费级 GPU 组成的单节点平台上,为大型混合专家模型(MoE)提供接近云端水平的推理服务质量。
MoE 模型每次推理只激活少量专家,这为 CPU–GPU 协同提供了可能:容量更大、单位容量成本更低的 CPU 内存负责容纳完整模型权重,GPU 则承担 attention、共享专家等计算密集型模块。KTransformers、llama.cpp 等系统已经表明,即使 GPU 显存远小于模型权重规模,CPU–GPU 混合推理仍可以支持 DeepSeek-R1/V3 等大型 MoE 模型在本地节点上运行。

图1 大型 MoE 模型的容量与带宽需求,以及 CPU/GPU 设备能力对比
但“能够运行”,并不等于“能够提供稳定的推理服务”。
此前的本地部署通常依赖 INT4 等低比特量化,或通过蒸馏、修改路由等方式缩减模型容量、开辟并行空间。即便模型成功运行,长上下文请求的首 token 等待时间、逐 token 解码速度,以及少量请求并发时的延迟稳定性,仍与云端服务通常追求的响应水平存在明显差距。
因此,我们希望进一步回答一个问题:原始 FP8 大型 MoE 在单个 CPU–GPU 节点上,能否跑出接近云端的服务质量?
研究团队将这一目标具体化为三个指标:在30秒 TTFT 预算内处理数万 token 的长上下文输入,使单请求解码速度达到约20 tokens/s,并在 prefill 与 decode 共存时尽可能限制相互干扰和延迟增幅。
固定的 CPU–GPU 分工,无法同时适配 prefill 和 decode
现有混合推理通常按照计算特征划分 CPU 和 GPU 的任务:Attention、共享专家等固定激活模块留在 GPU,参数量大但动态激活的路由专家则放在 CPU。
这种分工解决了显存容量问题,却很难同时适配 prefill 和 decode。
Prefill 会一次处理 prompt 中的大量 token。随着上下文变长,矩阵计算规模扩大,CPU 侧 MoE GEMM 逐渐从访存瓶颈转变为计算瓶颈。即使使用 AMX 指令和专用 GEMM 内核,这条路径仍然受到 CPU 计算吞吐上限约束。
Decode 每一步通常只生成一个 token,单次计算规模小,算术强度远低于 prefill。此时,专家权重读取、数据格式转换、线程同步和 NUMA 访问成为主要开销,大容量 CPU DRAM 反而仍然是合适的权重载体。
并发又带来第三种特征:Prefill 和 Decode 请求间、多个 Decode 请求间争抢硬件资源,如不改变资源分配方式,调度器只能在有限空间内尽力优化策略,但结果往往是 P/D 请求都承受巨大延迟。
因此,我们没有寻找一种贯穿所有负载的固定分工,而是围绕五项设计,分别重组 prefill、少卡并行、并发执行、FP8 算子和 CPU MoE 计算。
我们面向的也不是先进 CPU 节点,或者配备多张数据中心 GPU 和高速互联的集群,而是一类更典型的本地平台:双路 CPU 提供大容量 DRAM 和内存带宽,1–2张消费级 GPU 提供矩阵计算能力,但显存无法容纳完整模型,CPU 与 GPU 之间主要通过 PCIe 连接。
在主要实验平台上,两颗 AMD EPYC 9355 连接24个 DDR5-6400内存通道,总容量为1.15 TB、理论聚合带宽为1228 GB/s;GPU 为1–2张 RTX 5090,每张拥有32 GB显存。主要评测模型包括原始 FP8 DeepSeek-R1、Kimi-K2,以及用于量化性能对照的 Q4_K_M DeepSeek-R1。
长上下文 prefill 面临的第一重矛盾是:CPU 可以装下专家权重,却逐渐算不动;GPU 算得更快,却装不下完整模型。
KTransformers 等系统通过 AMX 指令和专用 CPU GEMM 内核提高 prefill 性能,在 2K prompt 下,吞吐可以超过500 tokens/s。但这条路径仍然受到 CPU 算术吞吐上限约束。随着输入增长至8K、16K和32K,CPU 侧 MoE 计算逐渐成为主要瓶颈,TTFT 约为20秒、40秒和100秒,后两个数字为基于已有性能结果的推算值。
另一条路径是 weight offloading:计算某个模块前,将相应权重从 CPU DRAM 搬入 GPU。这可以利用 GPU 算力,却可能让权重传输直接暴露在执行关键路径上。如果后续模块的权重没有及时到达,GPU 就只能等待 PCIe。
为突破 CPU prefill 的算力限制,我们的研究团队提出 Stream-Loading Prefill(SLP),通过三个并发线程和三条对应的 CUDA Stream,在亚层级粒度上将权重加载、GPU 计算与显存回收组织成一条相互重叠的流水线。
其中:
1. Loader 提前将后续模块的权重从 CPU DRAM 搬入 GPU;
2. Model 线程等待模块权重就绪,然后执行 GPU 计算;
3. Unloader 在计算结束后释放或复用对应的显存空间。
三个线程通过成对的 CUDA event 和 CPU 线程事件协调。Loader 完成模块加载后设置 ON event,Model 等待 ON event 再开始计算;模块执行结束后,Model 设置 OFF event,Unloader 等待该事件后回收显存。
完整权重的权威副本始终保留在 CPU 内存中,GPU 只保存当前计算和提前预取所需的有限部分。理想情况下,GPU 计算当前模块时,Loader 已经开始传输后续模块。只要计算能够覆盖足够多的传输时间,权重搬运暴露在 TTFT 关键路径上的比例就会下降。
SLP 不依赖专家预测、路由修改或权重量化压缩,而是通过连续的“加载—计算—回收”流水线,让权重传输尽可能与 GPU 计算重叠。

图2 Stream-Loading Prefill(SLP)执行流水线
流式加载真正落地时,首先遇到的并不是计算问题,而是显存管理问题。
以 DeepSeek-V3 的模型结构为例,58个 MoE 层、每层256个专家、每个专家3个 FP8 线性模块,对应:
即约4.45万个权重张量。如果每个张量都在使用前后单独执行 cudaMalloc 和 cudaFree,显存分配与释放本身就会产生可观开销,破坏加载—计算流水线。
为此,我们设计了跨层共享、人工管理的专家环形缓冲区。不同层的专家权重重复使用一组固定显存槽位,避免为数万个张量频繁申请和释放显存。
环形缓冲区的长度还会根据传输—计算平衡动态变化:
• 当 prompt 相对较短、权重传输仍占主导时,缓冲区长度设置为一层的专家数量,以扩大预加载窗口、尽量跑满主机到设备的传输带宽;
• 当 prompt 超过某个转折点,例如约50K,计算和中间张量开始主导资源占用,缓冲区缩小为两个槽位,以 ping-pong 方式维持重叠并控制显存峰值。
QKV 投影等数量较少、形状不规则的稠密权重不进入专家环形缓冲区。Loader 会在加载前检查剩余显存,使用约1 GB的固定空间暂存一层稠密权重,计算完成后再释放其临时分配。
因此,SLP 不只是为传统 weight offloading 增加异步预取,而是重新安排了权重生命周期、显存槽位和模块执行顺序。
SLP 有固定的权重传输和流水线启动成本。对于短 prompt,计算量不足以覆盖这些成本,CPU prefill 仍然更有竞争力。
我们的执行策略是:最多到4K tokens 使用 AVX FP8 CPU prefill,超过4K后切换至 SLP 或双 GPU DSLP。
在256–2K的短上下文区间,CPU baseline 仍具有优势;在4K附近,权重传输仍占据 SLP/DSLP 的显著延迟,因此相对 KT AMX 没有明显优势。进入8K–64K的长上下文区间后,流式加载的扩展趋势开始显现。
在主要实验平台上,单 GPU SLP 的 prefill 吞吐最高约为1200 tokens/s,并将32K prompt 控制在约30秒 TTFT 内。在20K–32K区间,SLP 相对 AVX baseline 提升超过一个数量级,相对推算的 KT AMX 性能约提升2.8倍。

图3 不同 prefill 长度下的 TTFT
这里的2.8倍需要与比较条件一起理解:相关 KT AMX prefill 结果来自 KTransformers 自己的实验平台,超过8K的数值则根据短上下文结果进行外推。这组数据更适合说明两种执行路径在长上下文下的扩展趋势,而不是完全同平台、同精度的直接性能对决。
SLP 也不是对 CPU prefill 的全面替代。它主要服务于计算量足以覆盖权重传输的长上下文请求。
单 GPU SLP 已经能够让权重流过 GPU,但增加第二张 GPU 后,问题不只是“把计算分成两份”。
Attention 与 MoE 的数据依赖不同,需要使用不同的并行方式。我们由此将 SLP 扩展为 Distributed Stream-Loading Prefill(DSLP)。
对于 Attention,DSLP 使用 zig-zag StripedAttention,将长序列沿上下文维度拆分到两张 GPU。每张 GPU 先对本地 KV 完成第一阶段因果注意力计算,随后通过一次环形 Pass-KV 交换剩余 KV,再完成第二阶段注意力。
对于 MoE,系统使用专家并行,将不同专家组分配给不同 GPU。标准专家并行先完成门控和排序,再通过 All-to-All Dispatch 将 token 发送给持有对应专家的 GPU;专家计算完成后,再通过 All-to-All Combine 将结果送回 token 原本所在的设备,最后执行加权归约。
因此,DSLP 同时包含三层设计:
数据中心的专家并行通常拥有更多 GPU 和高速互联。流量可以分散到多条链路,也更容易与其他计算重叠。
本地部署通常只有少量 GPU,主要依赖 PCIe,部分配置还缺少 GPU–GPU P2P。在这种条件下,标准专家并行的通信会集中到少量链路,Dispatch 和 Combine 的成本很快暴露出来。
在20K-token prefill、单个 decoder layer 的测量中,StripedAttention CP2与标准 EP2 的组合,相比单 GPU 顺序执行将层延迟降低约21%;但在所测的无 GPU–GPU P2P 环境中,Dispatch 和 Combine 仍然占据约31%的层延迟。
增加第二张 GPU 已经分摊了计算,MoE 通信却成为进一步扩展的主要障碍。

图4 20K-token prefill 下单个 decoder layer 的延迟拆解
针对少量 GPU、小规模专家并行和 PCIe 互联,我们提出 SmallEP。它的核心权衡是:接受少量本地重复计算,换取更少的跨卡通信。
假设全部设备共有  个 token,每个 token 激活
 个专家,专家并行规模为
 ,隐藏维度为
 。标准 EP 在每对设备之间的预期 Dispatch 通信量为:

Combine 阶段具有相同量级的通信成本。
SmallEP 改变了数据交换的顺序:
|
(a) Standard EP workflow. |
(b) SmallEP workflow. |


1. 先 All-Gather 尚未按专家展开的 token,使每个 rank 获得完整 token 集合;
2. 每个 rank 在本地重复门控和排序;
3. 只保留分配给本机专家的 token;
4. 专家计算完成后,先执行局部加权归约,将结果规约为  ;
5. 再交换这些部分规约结果,并在本地完成最终归约。
SmallEP 的 All-Gather 流量固定为每条链路  ,后续 All-to-All 交换的也是
 大小的部分规约张量,避免通信量随激活专家数
 膨胀。
按照通信量模型,当专家并行规模  不大于每个 token 的激活专家数
 ,即

时,SmallEP 的峰值单链路通信量低于标准 EP。
代价是每张 GPU 都需要对完整 token 集合重复执行一部分门控和排序。但测量显示,这部分冗余开销每层低于10毫秒,占端到端层延迟不到5%。
SmallEP 将 MoE 跨 GPU 通信量降低约50%。在20K-token prefill 的单层实验中,它相对标准 EP 进一步降低约18%的层延迟。结合 StripedAttention 后,双 GPU DSLP 达到单 GPU SLP 约1.64倍的 prefill 吞吐。
在两张 RTX 5090 上,DSLP 吞吐超过1800 tokens/s,并将约45K prompt 纳入30秒 TTFT。

图6 不同执行路径的 prefill 吞吐
SmallEP 面向的是少量 GPU、PCIe 互联和长上下文 prefill,并不是大规模集群专家并行的通用替代方案。
单请求性能提升后,本地推理仍需处理两类并发问题。
第一类发生在多条 decode 请求之间。不同请求会激活不同的专家,batch 增大时,实际需要读取的专家权重集合也随之扩大,CPU 内存带宽很快饱和。
第二类发生在 prefill 与 decode 之间。长上下文 prefill 会持续使用 GPU 和 PCIe,而 decode 需要稳定地逐 token 输出。如果两者共用一条执行路径,系统往往只能在 TTFT 与 TPOT 之间做取舍。
我们分别设计了双批次 Attention–MoE 重叠,以及节点内 prefill–decode 分离。
双批次重叠:让一个请求计算 Attention,另一个请求计算 MoE
在混合推理中,Attention 主要在 GPU 上运行,MoE 专家主要在 CPU 上运行。由于同一个 batch 内部存在计算依赖,两者通常按顺序执行:CPU 计算 MoE 时 GPU 空闲,GPU 计算 Attention 时 CPU 又得不到充分利用。
我们的测量显示,单层 Attention 约需要350微秒,MoE 计算约需要450微秒。这种交替执行产生了显著的硬件空转。
双批次 Attention–MoE overlap 为两个并发 batch 分别创建执行线程和 CUDA Stream,并将它们交错运行:当 Batch A 在 GPU 上执行 Attention 时,Batch B 在 CPU 上执行 MoE;随后两者互换。

图7 双批次 Attention–MoE 重叠执行
除 token embedding 和模型输出头等 GPU 独占操作外,大部分 Attention 与 MoE 都可以形成紧密流水线。前述独占操作的总开销低于5毫秒,相比61个 decoder layer 每 token 约50毫秒的主要执行时间较小。
在原始 FP8 DeepSeek-R1 上,单请求 decode 吞吐为21.5 tokens/s。两条等长请求并发时,系统总吞吐提高到33.6 tokens/s;上下文达到32K后,总吞吐仍为31.1 tokens/s。Batch size 为2时,每个请求维持16.8 tokens/s,相比单请求下降21.7%;作为对照,KT 在相应测试中从22.7降至13.6 tokens/s,降幅为40%。
因此,双批次重叠提高的是系统总吞吐和并发扩展效率,并不意味着增加并发完全没有单请求速度代价。
节点内分离:降低长 prefill 对 decode 的阻塞
SLP 将 prefill 的主要计算迁移到 GPU,只消耗较少 CPU 时间。基于这一特征,我们进一步在单个节点内分离 prefill 与 decode:一张 GPU 负责 SLP prefill,另一张 GPU 负责 decode 或短请求的 chunked prefill。
为了避免在 CPU DRAM 中保存两份完整模型权重,两条执行路径共享同一份常驻权重。进程间通过专家环形缓冲区共享权重,实现零拷贝并减少额外 DRAM 带宽消耗。
在 disaggregated SLP + decode 中,prefill 权重仍然需要经过 PCIe 5.0 x16进入 GPU;但相对于平台超过1 TB/s的 DRAM 带宽,这部分流量对 decode 的影响较小。
调度策略也不再只有 chunked prefill 一种选择:
• 低于约2K的短请求使用 chunked prefill;
• 对于长 prefill,如果短时间窗口内没有 decode 请求,则使用 DSLP 提高吞吐;
• 如果存在 decode 请求,则使用分离的单 GPU SLP,以优先保持 decode 延迟;
• Decode 请求动态组成小 batch,在延迟和效率之间平衡。
并发实验覆盖单 prefill、单 decode、prefill + decode、双 decode,以及 prefill + 双 decode 等负载。1P与1P+1D场景下,prefill TTFT基本稳定;在1P+2D场景中,decode 带来的额外 DRAM 流量会延迟 SLP 权重传输,使 TTFT 增加约18%。
从 decode 角度看,KT 在 prefill 与 decode 共存时,平均 TPOT 最多上升到单 decode baseline 的2.45倍;我们的最大增幅为1.54倍。总工作负载延迟方面,我们的最差增幅为1.67倍,KT则为2.53倍。

图8 并发工作负载下的 TTFT、TPOT 与总延迟归一化结果
这些结果说明,节点内分离可以明显缓解 prefill 与 decode 的相互干扰,但并不会消除所有资源竞争。并发 decode 增加后,DRAM 带宽仍会压缩 SLP 权重传输的余量。
原生 FP8 GEMV:不生成完整 BF16 权重副本,减少 CPU 访存
Prefill 适合借用 GPU 算力,decode 的关键却仍然在 CPU。
小 batch decode 的算术强度很低,主要受内存带宽限制。对于原始 FP8 模型,CPU 还面临额外困难:现代 GPU 已经提供成熟的 FP8 计算单元,通用 CPU 却没有对应的原生 FP8 执行能力。
传统路径通常先将 FP8 权重扩展或反量化为 BF16,再执行 GEMV。这不仅增加格式转换开销,也可能扩大中间数据的内存占用和访存量。
为此,我们开发了面向 MoE decode 的 AVX-512 FP8 GEMV kernel,直接读取 E4M3FN FP8 权重,并通过整数位操作完成格式处理。
标准实现需要先将 FP8 扩展至 FP32、应用 scale inverse并修正指数偏置,再截断为 BF16,最后执行 BF16 dot product。这条路径涉及超过15条向量指令,同时受到 FP32 寄存器密度限制。
优化后的 post-scaling 路径将 FP8 权重直接展开为 BF16,加载 BF16 activation,通过 vdpbf16ps 累加至 FP32,最后再对累加结果统一应用 scale。这样可以避开热路径中的频繁 FP32 转换,并将每个512位寄存器的有效元素数量从16个 FP32 提高到32个 BF16。

图9 AVX-512 FP8–BF16 点积的 post-scaling 路径
在此基础上,我们又将 GEMV 循环组织为三个层次:
• 沿输出维度  进行 tiling;
• 沿输入维度  以通常128个元素为一个 scale block;
• 在 block 内通过 SIMD dot product 完成流水化累加。

图10 FP8 GEMV 内核的层次结构
同一 scale block 内的部分点积先全部累加,再统一应用一次 inverse scale,相比基线 post-scaling kernel 将相关乘法次数减少4倍。
初步 post-scaling kernel 的有效内存带宽达到815 GB/s;进一步完成 tiling 和 scale-block 优化后,带宽提高到947 GB/s。
在真实 MoE GEMV 负载下,优化后 kernel 的延迟为15.5微秒,标准 FP8实现为21.7微秒。作为对照,OpenBLAS FP32为69.5微秒,AOCL-BLAS FP32为59.2微秒,AOCL-BLAS BF16为69.5微秒。相对于这些 CPU BLAS 路径,优化后的 FP8 GEMV 将延迟降低约4–5倍。
这组结果是算子级测试,不意味着端到端模型推理会获得相同倍数的提升。它解决的是原始 FP8 权重在 CPU 上缺少高效 GEMV 路径的问题。
CPU 细粒度并行:减少同步与跨 NUMA 通信,释放 decode 带宽
高效 kernel 只是基础。要把单个算子的带宽转化为完整 MoE 模型的 decode 速度,还需要处理专家之间、投影之间和 NUMA 节点之间的并行关系。
每个 MoE 专家包含 gate、up 和 down 三组投影。Gate 和 up 可以并行执行,但它们的输出需要在激活和逐元素相乘后,才能作为 down projection 的输入。
简单的全局 barrier 会让所有线程等待最慢的专家或任务,产生显著同步开销。为此,我们同时在两个维度上拆分计算:
• 在专家之间,将激活专家分配到 NUMA 节点内的不同核心;
• 在单个专家内部,沿输出维度  将 GEMV 切分为多个独立任务。
每个专家使用自己的细粒度 barrier。只要该专家的 gate 和 up 完成,就可以执行激活、乘法并进入 down,而不需要等待其他专家。我们还将 gate/up 之后的 combine 操作融合进第一阶段,进一步降低同步开销。
针对 Q4_K_M 等量化模型,执行路径还涉及 FP32、Q8_K、BF16等格式之间的多次转换。我们将 gate/up 和 down 的输入转换融合进对应投影,将输出转换融合进 down,减少 kernel launch,并将每个 MoE 层的全局同步限制在 gate/up combine之后和 down之后两次。
最终,在短上下文测试中,Q4_K_M DeepSeek-R1 达到28 tokens/s,ik_llama.cpp约为14 tokens/s,KTransformers约为22 tokens/s。相对 KTransformers,吞吐提高约25%。当上下文增长到128K时,我们的量化执行仍维持约19 tokens/s,而 KTransformers约为15 tokens/s。
在原始 FP8 模型上,DeepSeek-R1短上下文 decode 吞吐达到21.5 tokens/s,并在32K上下文内维持约20 tokens/s;Kimi-K2 的单请求吞吐约为22.4 tokens/s。

图11 原始 FP8 DeepSeek-R1 671B 与 Kimi-K2 1T 的 decode 吞吐
这些端到端结果来自 FP8 GEMV、细粒度同步、NUMA 调度和算子融合的共同作用,不能只归因于其中某一个 kernel。
五项设计最终需要回到开篇提出的四个问题:原始模型能否直接运行、长上下文能否控制 TTFT、单请求 decode 能否维持响应速度、并发时能否减少性能退化。
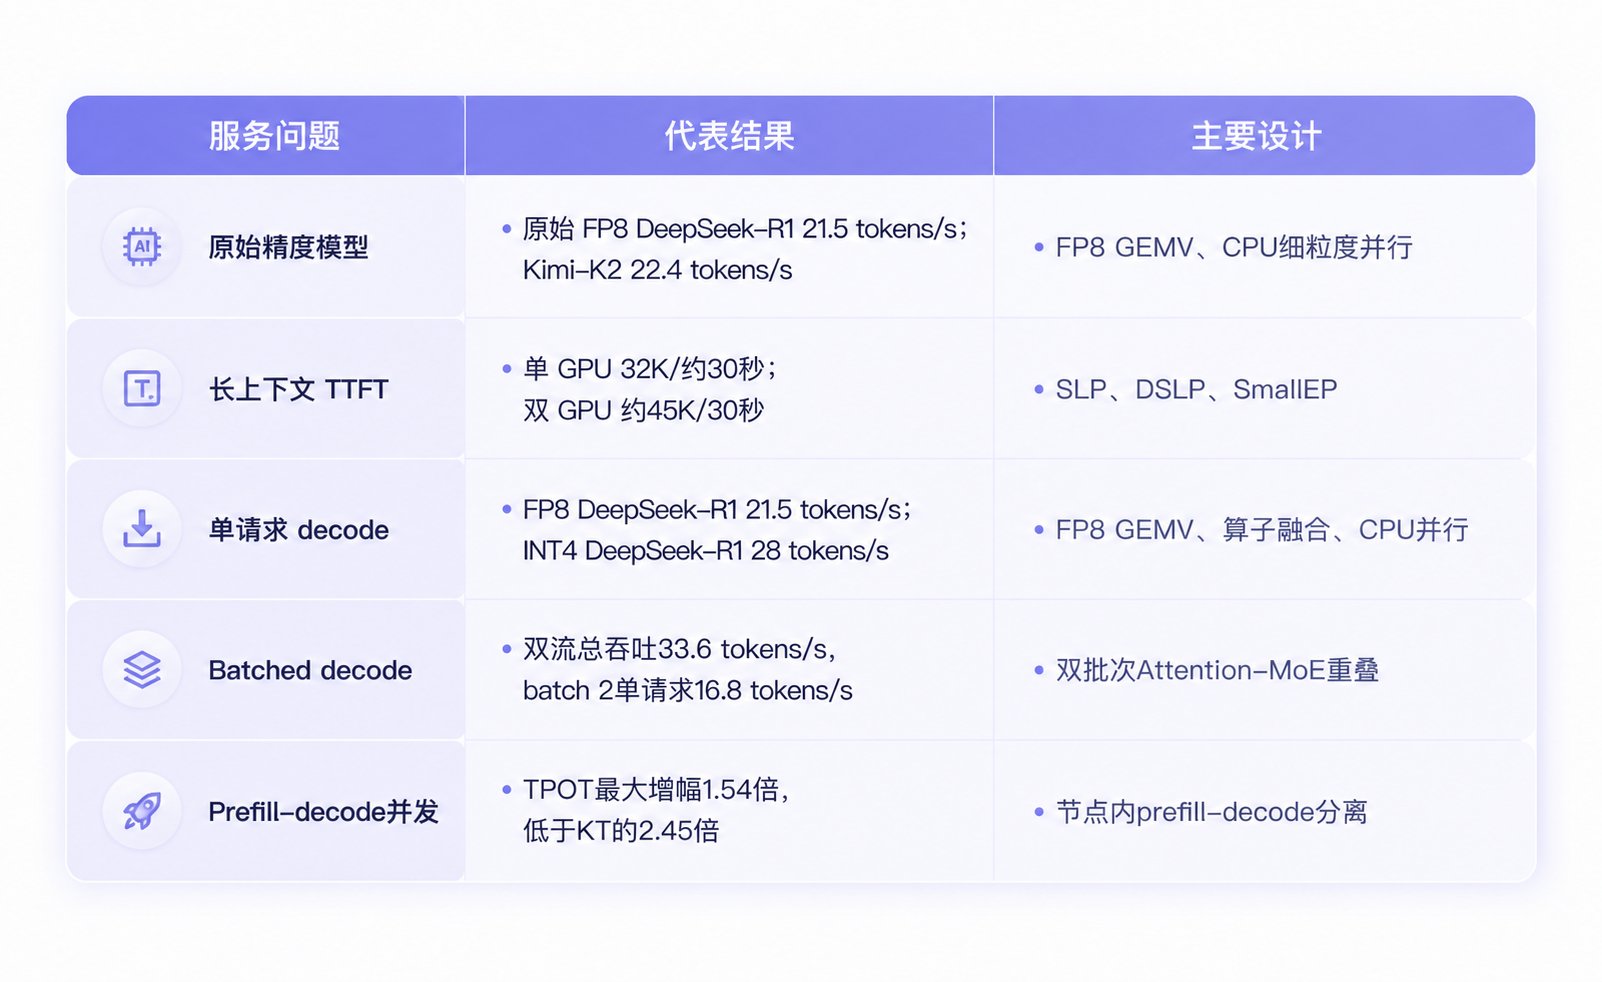
在主要实验平台上
模型质量评测进一步比较了我们的执行结果与模型官方结果。在 MMLU-Redux 和 MMLU-Pro 上,DeepSeek-V3.1与Kimi-K2-Instruct的 Exact Match 得分与官方参考值相差约1–1.2个百分点以内。
这为“原始模型能力没有因系统执行路径产生系统性损失”提供了支持,但仍应注意,评测只覆盖了两个 benchmark,得分差异也可能受到生成配置等因素影响。
这套系统面向的是大容量双路 CPU、1–2张消费级 GPU 和 PCIe 互联组成的本地节点。向其他硬件迁移时,瓶颈会随资源条件变化。
对于较低端 CPU,小 batch decode 的主要限制仍是有效 DRAM 带宽。MoE 中的 skinny GEMM 算术强度大约为 batch size 的两倍;本地常见 batch size 为1–4,远低于现代 CPU 的计算—内存比。我们的测量中,CPU 侧 MoE 约占 decode 总时间的60%,双批次执行时暴露得更多。因此,decode 性能预计会随可用 DRAM 带宽近似变化。
对于低显存或中端 GPU,SLP/DSLP 的效果取决于专家环形缓冲区容量,以及能否充分重叠传输与计算。
在约16K的中等长度下,默认的一层完整专家缓冲区最有利于平滑层内传输与计算的不均衡。DeepSeek-V3和Kimi-K2需要约11.3–16.9 GB环形缓冲空间;双 GPU 分布后,每张卡约需要5.6–8.5 GB。如果显存不足以提供相应缓冲,传输—计算重叠会减弱,TTFT可能上升。
在超过约50K的超长 prefill 中,工作负载逐渐由计算而不是传输主导,性能会更多取决于 GPU 本身的计算能力。
这项工作的意义,并不是为所有硬件配置给出一套统一的性能答案,而是验证了一条可行路径:在双路 CPU、消费级 GPU 与 PCIe 组成的本地节点上,通过对计算、存储与通信的系统级协同,原始精度的旗舰 MoE 模型同样可以获得接近云端的推理体验。
论文地址:https://arxiv.org/abs/2606.10493

